Архитектура кластера: управляющая и пользовательская плоскости
Внутри кластера компоненты разделены на управляющую (Control Plane) и пользовательскую плоскости (User Plane).
Пользовательская плоскость реализует транспортные функции — прием, обработку и передачу трафика абонентов.
Одной из ключевых функций User Plane является DPI — система классификации трафика по сессиям и приложениям. DPI-узлы принимают пакеты, обрабатывают соединения, применяют необходимые политики и ведут статистику потребления абонента. Именно эти узлы добавляются при увеличении емкости или выводятся из работы при обслуживании.
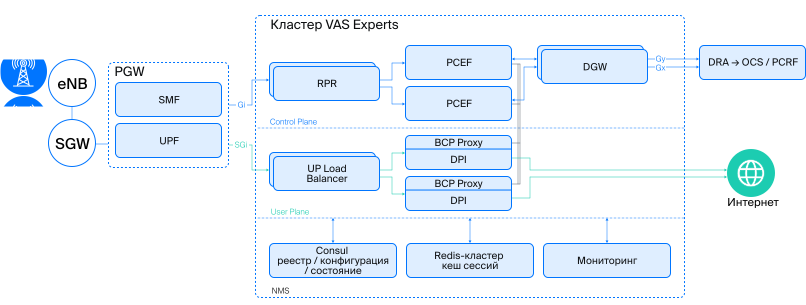
Рисунок 1 — Архитектура кластера
Управляющая плоскость хранит состояние абонентской сессий и назначает пользовательскую плоскость. По данным о числе работающих узлов она определяет, какой узел обслуживает конкретного абонента, какие параметры и услуги к нему относятся, и реализует перенос сессии при изменении этого назначения.
Требование, из которого все вытекает
Начнем не с масштабирования, а как раз с ограничения, которое ему мешает.
Классификация трафика и посервисный учет требуют, чтобы оба направления соединения обслуживал один и тот же узел DPI (User Plane).
К тому же, единицей обслуживания является не отдельный IP-адрес и даже не одно соединение. Один абонент одновременно может использовать несколько сервисов, иметь несколько подключений, работать по IPv4 и IPv6 или раздавать интернет другим устройствам. Поэтому один абонент может иметь несколько подключений и адресов, но с точки зрения обслуживания они относятся к одной сервисной сессии. Именно она становится единицей масштабирования: все связанные с абонентом подключения должны обслуживаться вместе, одним узлом обработки трафика и одним узлом управления.
Единицей масштабирования является не поток, не адрес и не отдельное соединение, а сама сервисная сессия со всеми ее параметрами: подключениями, IPv4- и IPv6-адресами, тарифом, квотой, учетом. Это и есть единица распределения, которую нельзя дробить между узлами.
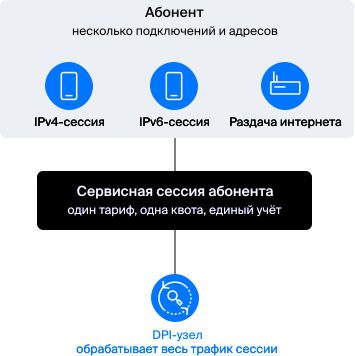
Рисунок 2 — Сервисная сессия: все подключения и адреса одного абонента — одна единица обслуживания
Если пакеты одного TCP-соединения попадут на разные узлы, это может привести к разрыву соединения, потере контекста классификации и разделению одной сессии между несколькими узлами при учете трафика.
Особенно наглядно это видно на примере сервиса NAT. Если трансляция адреса и порта хранится на старом узле, а следующий пакет попадает на новый, новый узел не найдет соответствующей записи и трафик будет отброшен. Для установленного соединения это будет причиной обрыва.
Два способа распределить абонентов между узлами и разница между ними
Как распределять новые сессии между узлами так, чтобы пакеты каждой конкретной сессии всегда попадали на один и тот же узел?
Хэширование по идентификатору абоненту
Одним из распространенных и эффективных способов является расчет по хэшу, который вычисляется по паре IMSI/APN PDN сессии абонента. Берем идентификатор абонента IMSI+APN, вычисляем его хэш, сопоставляем результат со списком работающих узлов и получаем номер узла, на который должна попасть сессия. Поскольку у абонента один IMSI, все его сессии в одном APN, независимо от используемого IP-адреса (IPv4 или IPv6), направляются на один и тот же узел обработки. Способ позволяет не синхронизировать состояние между узлами: каждый из них, имея одинаковую информацию о составе кластера, самостоятельно получает одинаковый хэш и номер узла.
При добавлении нового узла алгоритм (например, Maglev или Randevu) перестраивает распределение так, чтобы изменить маршрутизацию только для минимальной части абонентов — примерно для 1/(N+1) от общего числа при увеличении кластера с N до N+1 узлов. Остальные продолжают обслуживаться там же.
Но и здесь есть принципиальный недостаток: алгоритм не учитывает текущее состояние обслуживания сессии на узле.
Как только новый узел добавляется в кластер, для части абонентов результат хэширования меняется. Алгоритм направит их новые соединения на другой узел. При этом на прежнем узле может оставаться контекст обслуживания этих абонентов: информация о подключениях, счетчики потребления и другие данные, необходимые для обработки текущих сессий. На новом узле этого состояния еще нет. Если сразу применить новое распределение, активные сессии окажутся на узлах, где нет их контекста. Поэтому недостаточно обеспечить условия, чтобы каждое отдельное соединение попадало на правильный узел. Связанный с абонентом контекст тоже должен оставаться целостным.
Первичное размещение и управляемый перенос
Хеширование хорошо решает только одну часть задачи — первичное распределение. Дальше встает вопрос: «Что делать с сессиями, которые уже работают?». Чтобы решить эту проблему стоит разделить два процесса: первичное размещение новых сессий и управляемый перенос уже существующих.
Управляемый перенос
Для новых сессий по-прежнему используется хеширование — оно быстро и равномерно распределяет нагрузку, а заодно служит резервным режимом, если управляющая плоскость временно недоступна. А для действующих сессий нужен отдельный механизм, который позволит распределять сессии постепенно.
Эту задачу решает PCEF — компонент управляющей плоскости. При изменении числа DPI-узлов PCEF проходит по всем своим сессиям. Для каждой он сравнивает текущую привязку к узлу с целевой, вычисляемой консистентным хэшем с учетом нового числа узлов. При расхождении PCEF переключает сессию на целевой узел. Так реализуется плавная миграция пользовательской плоскости.
Поэтому при добавлении нового узла обработки трафика управляющая плоскость может не пересчитывать всю систему заново, а выбрать конкретные сессии для переноса.
Аналогично устроено масштабирование и самой управляющей плоскости — экземпляров PCEF. Если их число увеличивается, каждый действующий PCEF проходит по сессиям, которые обслуживает сам, и для тех, что по новому хешу теперь должны принадлежать добавленному экземпляру, освобождает их. Если число PCEF уменьшается — например, один из экземпляров вышел из строя, — оставшиеся проходят уже не только по своим, а по всем сессиям в общем хранилище, находят те, что остались без владельца, и забирают себе те из них, что по актуальному хешу теперь их.
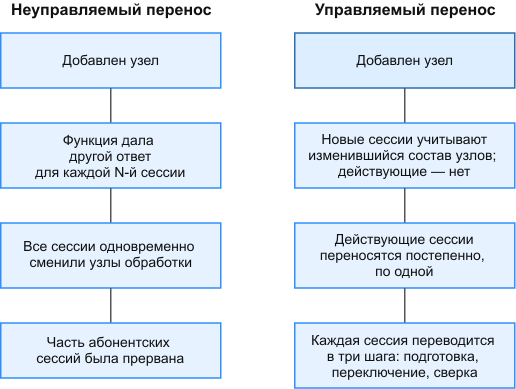
Рисунок 3 — Два способа распределить сессии абонентов по узлам
Например, оператор добавил новый узел DPI. Новые подключения сразу начинают попадать на него. Затем управляющая плоскость постепенно выбирает часть действующих сессий и переводит их с перегруженных узлов. После подготовки состояния назначение меняется, и дальнейший трафик идет уже по новому маршруту.
Для абонента при этом ничего принципиально не меняется: видеозвонок продолжается, загрузка файла не начинается заново, а накопленный учет сохраняется.
Сам узел балансировки исходящего трафика (UP load Balancer) при этом не принимает решение о перераспределении. Он получает команду, подготавливает состояние сессии и продолжает обработку уже после переключения. Это принципиальное отличие от схемы, где каждый узел самостоятельно вычисляет свое назначение по хешу.
Получается разделение ролей: управляющая плоскость вычисляет целевое назначение и выполняет перенос, а пользовательская плоскость обрабатывает трафик уже по этому назначению.
Подробнее об управляющей и пользовательской плоскости можно узнать в статье — CUPS для PCEF/PGW: зачем разделять Control Plane и User Plane в мобильном ядре.
Цена управляемости
Чтобы управляемый перенос работал корректно нужно обеспечить согласованность данных, на основе которых PCEF принимает решения, контролировать скорость миграции и учитывать сессии, состояние которых нельзя безопасно перенести, например NAT.
Согласованность данных о составе узлов
Узлы пользовательской плоскости не вычисляют назначение сами — они получают его от управляющей плоскости и применяют к обработке трафика. Поэтому важно гарантировать, что каждый узел действительно работает с актуальной версией.
При каждом изменении количества узлов, PCEF вычисляет целевой узел для каждой сессии на основе нового числа DPI-узлов, которое он берет из Consul. Если в кластере несколько PCEF, важно, чтобы все они видели одно и то же число узлов в один и тот же момент — иначе разные экземпляры PCEF вычислят для одной и той же сессии разные целевые узлы, и распределение перестанет быть согласованным.
Перевод занимает время
Перенос одной сессии занимает доли секунды, но сессий — миллионы, и их приходится переносить последовательно, а не разом. Перенос занимает время, зато действующие сессии не прерываются.
Не все переводится
Наконец, не все сессии одинаковы с точки зрения переносимости. Часть их состояния можно безопасно скопировать на другой узел, а часть жестко привязана к конкретному оборудованию, на котором она была создана. NAT — один из таких случаев: запись трансляции адреса и порта существует только в памяти конкретного узла, и ее нельзя просто воссоздать на другом узле без риска потерять уже установленные соединения.
Такие сессии выводятся из обслуживания иначе — не переносом, а естественным завершением: узел перестает принимать на себя новые сессии, а старые продолжают обслуживаться на нем до собственного завершения.
Как проверить, что это работает: три измеримых критерия
Все описанное выше — хеширование по IMSI, управляемый перенос — существует не само по себе, а ради трех конкретных свойств, которые можно измерить на реальном трафике, а не продекларировать.
| Свойство | Как проверяется | Если свойство нарушено |
| Оба направления сессии на одном узле | Проверяется, обрабатываются ли входящий и исходящий трафик одной сессии на одном узле | Посервисный учет и классификация могут быть неполными |
| Перевод без потери пакетов | Проверяется, продолжается ли передача трафика без перерыва во время перевода сессии | Абонент может заметить обрыв соединения |
| Перевод без потери учета | Проверяется, совпадает ли суммарный объем учета на исходном и новом узлах с фактическим потреблением | Ошибка учета может обнаружиться только при формировании итогового отчета |
Третье свойство стоит подчеркнуть отдельно. При управляемом переводе исходный узел перед завершением передает итоговые данные о потреблении. Управляющая плоскость объединяет их с данными нового узла и корректирует порог потребления. Поэтому данные не теряются и не учитываются повторно.
При этом сессию тарификации не нужно закрывать и открывать заново. Абонент продолжает пользоваться услугой без прерывания, а учет потребления продолжается с учетом данных обоих узлов.
Что дает такое масштабирование
Главное преимущество такого подхода — оператор может менять состав инфраструктуры без массового перераспределения действующих сессий. Новый узел можно сразу использовать для новых подключений, а существующие переводить постепенно, по мере необходимости.
Это дает несколько практических эффектов:
- Емкость можно наращивать без остановки сети. Новый узел начинает принимать подключения сразу, а перенос действующих сессий выполняется в фоне.
- Нагрузка выравнивается адресно. Перегруженный узел разгружается ровно в том объеме, который необходим, а не за счет полного перерасчета соединений.
- Состояние абонента остается целостным. Его подключения, адреса, тариф, квота и посервисный учет не распадаются между несколькими узлами.
- Плановые работы не превращаются в аварийные переключения. При выводе узла его сессии можно заранее перевести на другие узлы, а не обрывать все соединения одновременно.
Рост сети измеряется терабитами, а результат масштабирования ощущается на уровне отдельного соединения. Архитектура, в которой единицей распределения выбран не поток и даже не отдельная сессия, а абонент со всем, что к нему привязано, просто не позволяет забыть об этом на этапе проектирования.